

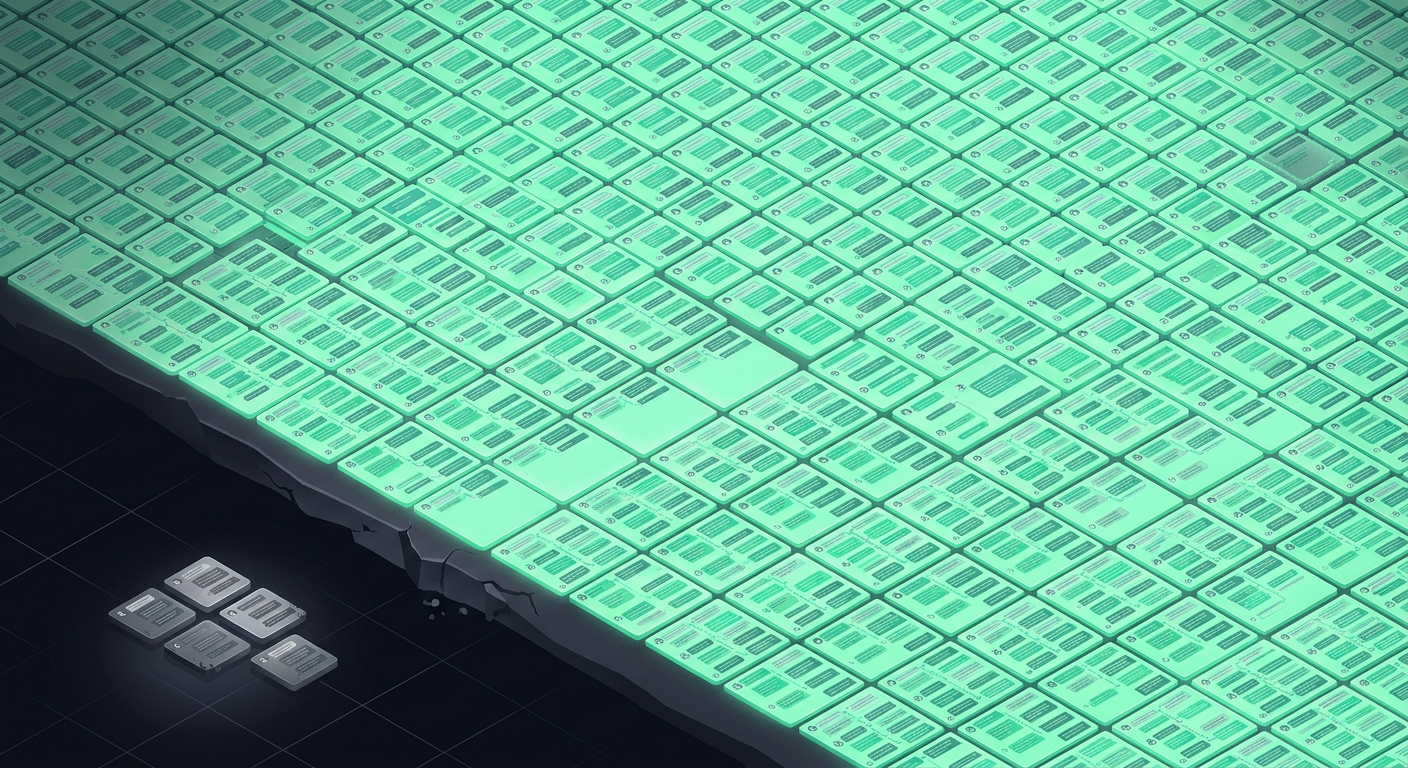
Standar lama di banyak tim customer service adalah supervisor memeriksa lima sampai sepuluh percakapan per agen per bulan. Kalau satu agen menangani seribu percakapan sebulan, itu berarti kurang dari satu persen pekerjaannya yang dinilai. Kesimpulan tentang kualitas layanan seluruh tim lalu dibangun di atas sampel sekecil itu.
Konsekuensinya bukan hanya penilaian yang tidak akurat, tapi juga masalah keadilan. Agen yang kebetulan sampelnya jelek dinilai buruk, agen dengan sampel bagus dinilai baik, padahal keduanya bisa saja sama.
Supaya penilaian menyeluruh tetap konsisten, kriteria harus sedikit dan bisa dijelaskan. Lima dimensi ini sudah cukup untuk sebagian besar tim:
Menilai seribu percakapan per agen secara manual jelas mustahil. Peran AI di sini bukan menggantikan supervisor, melainkan mengubah pekerjaan supervisor dari membaca menjadi memutuskan.
Alur yang praktis: sistem membaca seluruh percakapan, memberi skor pada lima dimensi di atas, lalu menyodorkan tiga daftar pendek ke supervisor. Pertama, percakapan berisiko tinggi yang perlu ditangani hari itu juga. Kedua, pola kesalahan berulang yang perlu jadi materi pelatihan. Ketiga, contoh percakapan terbaik yang layak jadi contoh untuk tim.
Supervisor tetap membaca, tapi membaca tiga puluh percakapan yang benar-benar penting, bukan sepuluh percakapan acak.
Audit menyeluruh bisa menjadi bumerang kalau dipakai untuk mencari kesalahan. Beberapa prinsip yang menjaga kepercayaan tim:
Justru sebaliknya kalau kriterianya transparan dan hasilnya dipakai untuk membela tim ketika beban kerja terlalu tinggi. Yang membuat tim resah adalah penilaian rahasia dengan sampel acak.
Kriteria penilaian tetap sama. Yang perlu dipastikan adalah sistem analisis memahami bahasa dan gaya bicara yang benar-benar dipakai pelanggan Anda.
Tidak. Survei mengukur persepsi, audit percakapan mengukur perilaku. Keduanya saling melengkapi, tapi audit percakapan mencakup seratus persen pelanggan sementara survei hanya mencakup yang mau mengisi.
Ambil satu bulan percakapan yang sudah lewat, jalankan penilaian menyeluruh, lalu bandingkan hasilnya dengan penilaian sampling yang selama ini dipakai. Selisihnya biasanya cukup mengejutkan. Detail ada di halaman solusi WhatsCRM Hub.
Your email address will not be published. Required fields are marked *
Sign in to leave a comment
3 Comment